在选择台湾原生站群时,首要考虑的是网络质量与延迟。优先选择具有多上游骨干、BGP优化、到中国大陆/东南亚延迟低的机房。评估带宽阶梯、流量计费与出口稳定性,确认是否支持异地备援。
选择支持IPv4/IPv6、反向解析和自定义路由的供应商。同时关注机房的物理安全、电力冗余与硬件可维护性。
比较按流量计费与包年包月的成本,优先考虑能快速横向扩容的方案以便未来扩展站群数量。
推荐采用分层架构:边缘层(反向代理/负载均衡)、应用层(Web/应用服务)、数据层(数据库/缓存)。通过容器化或虚拟化实现一致部署,用基础镜像与自动化脚本保证环境一致性。
使用Nginx/HAProxy/Traefik做反向代理,配合健康检查、防火墙规则与会话粘性设置,确保请求能智能分配到节点。
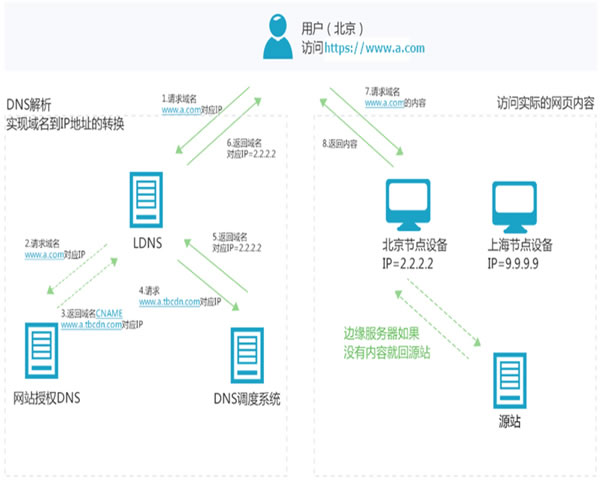
统一通过DNS管理平台配置多域名解析,自动化签发与续期SSL证书(例如Let's Encrypt),降低人工运维成本。
对站群使用泛域名或子域名策略,并利用DNS TTL调整实现灰度切流与快速回滚。
安全包含网络边界、应用防护与数据加密。部署WAF、DDoS防护与入侵检测,同时对敏感数据进行传输与存储加密,满足当地隐私与合规要求。
在机房或上游接入云端清洗服务,结合主机级的WAF规则减少HTTP层攻击。针对站群流量特点制定白名单与速率限制策略。
采用跨机房异地备份、快照与冷备相结合的策略,定期演练恢复流程并检查备份完整性。
性能优化从前端到后端全链路考虑:静态资源使用CDN缓存、开启Gzip/Brotli压缩、合理设置Cache-Control;后端使用缓存层(Redis/Memcached)、数据库索引与连接池优化。
结合台湾本地CDN节点降低首跳延迟,对图片、JS、CSS等静态资源实施长时缓存并使用版本化文件名以便强缓存刷新。
分析慢查询、添加必要索引、拆分读写(主从或分片)、并使用连接池与ORM优化查询频次。
使用ab/jMeter/Locust进行压测,设置真实流量模型并监控CPU、内存、响应时间与QPS,根据瓶颈调整资源与配置。
构建从日志、指标到告警的完整观测平台,采用Prometheus+Grafana或商业监控服务收集关键指标(CPU、内存、响应时间、错误率)。日志集中化可用ELK/EFK。
设置多级告警策略(信息、警告、严重),结合自动化脚本实现故障自愈(如自动重启服务、扩容节点、切换流量)。
用CI/CD流水线实现代码构建、镜像发布与蓝绿/滚动部署。通过不可变基础镜像与配置托管减少环境漂移风险。
定期进行故障演练与演习,将操作步骤、回滚流程和权限管理文档化,确保团队能在紧急情况下快速响应。